

كشف جاك دورسي، المؤسس المشارك لمنصة تويتر، عبر شركته «بلوك» (Block)، عن نموذج ذكاء اصطناعي جديد يحمل اسم «Dessa»، يستهدف جعل المحادثات الصوتية أكثر طبيعية وقربًا من التواصل البشري، مع إمكانية تشغيله محليًا على أجهزة ماك بوك المتطورة دون الحاجة إلى الاتصال بالإنترنت. ويأتي النموذج ضمن توجه بحثي يسعى إلى تطوير أنظمة قادرة على الاستماع والتحدث مباشرة، بدلًا من الاعتماد على تحويل كلام المستخدم إلى نص مكتوب ثم معالجة النص وإنتاج رد صوتي. ووفقًا للمعلومات المعلنة عن المشروع، يركز «Dessa» على فهم الإشارات الصوتية، مثل نبرة الحديث والتوقفات والضحك والسخرية، بما قد يساعده على التفاعل بصورة أكثر سلاسة. كما يثير المشروع اهتمامًا بسبب اعتماده على أسلوب مختلف عن النماذج اللغوية الضخمة التقليدية. ومع ذلك، لا يزال النموذج في مرحلة البحث والتطوير المبكر، ويخضع للتقييم من جانب باحثين متخصصين في سلامة الذكاء الاصطناعي، قبل اتضاح قدراته العملية وحدود استخدامه.
نموذج Dessa للذكاء الاصطناعي.. كيف يتحدث مثل البشر؟
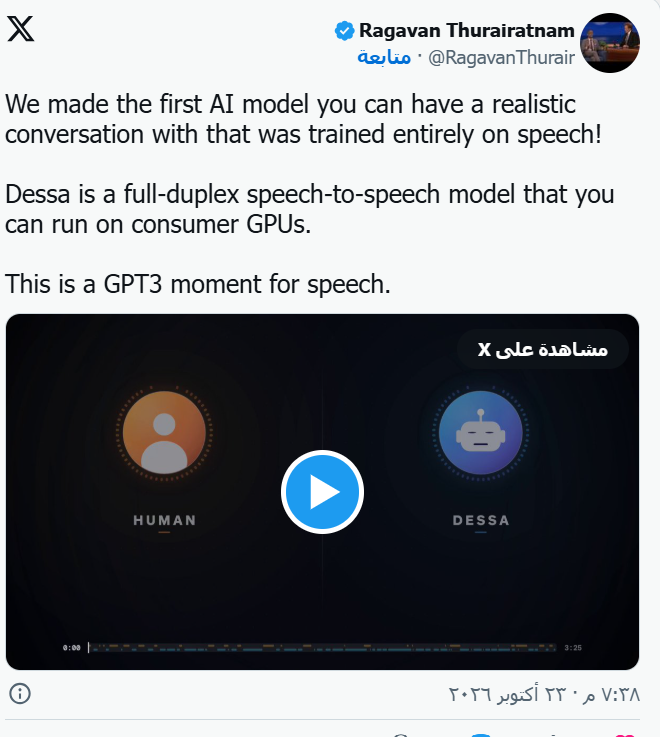
يعتمد نموذج «Dessa» على تقنية المحادثة الصوتية المباشرة، المعروفة باسم «Full-Duplex Speech-to-Speech»، التي تتيح للنظام الاستماع والتحدث في الوقت نفسه. ويختلف هذا الأسلوب عن بعض المساعدات الصوتية التقليدية التي تبدأ بتحويل كلام المستخدم إلى نص، ثم تحليل النص وتوليد إجابة صوتية. ويمكن أن يؤدي التعامل المباشر مع الصوت إلى الاحتفاظ بمعلومات إضافية، مثل نبرة المتحدث وسرعة كلامه والتوقفات التي يستخدمها أثناء الحديث. ويستهدف المشروع الاستفادة من هذه التفاصيل لجعل التفاعل أكثر طبيعية، مع ضرورة اختبار مدى دقة النموذج في فهم السياقات المختلفة والاستجابة لها بصورة مناسبة.
تقنية المحادثة الصوتية المباشرة في Dessa
تتيح تقنية الصوت إلى الصوت للنموذج التعامل مع الإشارات الصوتية مباشرة، بدلًا من الاعتماد الكامل على النص المكتوب كمرحلة وسيطة. وتكتسب هذه الطريقة أهمية لأن الحديث البشري لا يتكون من الكلمات وحدها، بل يشمل أيضًا نبرة الصوت والإيقاع والتردد والضحك والتوقفات. وقد تساعد هذه المعلومات النظام على فهم المقصود من بعض العبارات بصورة أفضل، خاصة عندما تتغير دلالتها وفقًا لطريقة نطقها. ومع ذلك، فإن القدرة على التقاط هذه الإشارات لا تعني بالضرورة فهم المشاعر البشرية بدقة كاملة، إذ يحتاج الأمر إلى اختبارات تقيس أداء النموذج في مواقف محادثة واقعية ومتنوعة.
كيف يتعامل النموذج مع المقاطعة والضحك والمشاعر؟
بحسب المعلومات المنشورة عن المشروع، يستهدف «Dessa» إجراء محادثات أكثر مرونة، من خلال الاستجابة السريعة وإتاحة التداخل الطبيعي بين الحديثين، بدلًا من انتظار انتهاء كل جملة في جميع الحالات. كما يُفترض أن تساعده طريقة التدريب على التقاط بعض الإشارات، مثل الضحك والسخرية وتغير نبرة الصوت. ويمكن لهذه الخصائص أن تجعل المساعد الصوتي أقرب إلى إيقاع المحادثات اليومية، خاصة في الحوارات التي تتطلب ردود فعل سريعة. لكن مدى نجاحه في تفسير المشاعر أو التمييز بين المزاح والجدية يحتاج إلى تقييم مستقل، ولا ينبغي اعتبار هذه القدرات مضمونة قبل ظهور نتائج اختبارات موثوقة.
تشغيل Dessa دون إنترنت على أجهزة ماك بوك
من أبرز الجوانب المثيرة للاهتمام في النموذج إمكانية تشغيله محليًا على أجهزة ماك بوك ذات الإمكانات العالية، وفقًا للتقرير المنشور عن المشروع. ويشير التشغيل المحلي إلى تنفيذ عمليات المعالجة على الجهاز نفسه بدلًا من إرسال كل البيانات إلى خوادم سحابية. وقد يتيح ذلك استخدام بعض وظائف الذكاء الاصطناعي دون اتصال دائم بالإنترنت، مع تقليل الاعتماد على الخدمات الخارجية. إلا أن هذه الإمكانية ترتبط بمتطلبات الجهاز والموارد الحسابية اللازمة لتشغيل النموذج. كما أن التشغيل المحلي لا يضمن وحده حماية البيانات بصورة كاملة، إذ تظل الخصوصية مرتبطة بطريقة تصميم البرنامج وتخزين المعلومات وإدارة الأذونات.
ما متطلبات تشغيل نموذج Dessa محليًا؟
أشار التقرير إلى أن تشغيل «Dessa» يتطلب جهاز «MacBook Pro» مزودًا بمعالج «M4 Max» أو جهازًا أعلى قدرة. ويعكس هذا الشرط أهمية الموارد الحاسوبية عند تشغيل نماذج صوتية متقدمة على الأجهزة الشخصية، خاصة عندما تحتاج إلى معالجة الصوت بصورة مستمرة والاستجابة في الوقت الفعلي. كما ذكر التقرير أن تدريب النموذج جرى باستخدام نظام حوسبة من إنفيديا يحمل اسم «GB200 NVL72»، وهو ما يوضح اختلاف متطلبات مرحلة التدريب عن متطلبات التشغيل على جهاز المستخدم. وينبغي متابعة التفاصيل التقنية الرسمية لمعرفة متطلبات الذاكرة والتوافق والإصدارات المدعومة، وعدم افتراض أن النموذج متاح للتثبيت العام على جميع أجهزة ماك.
جاك دورسي يوضح فلسفة تطوير النموذج
رد جاك دورسي على أسئلة المستخدمين عبر منصة «إكس» بشأن التقنية المستخدمة في «Dessa»، موضحًا أنه يعتمد على أسلوب الصوت إلى الصوت دون استخدام نموذج لغوي ضخم تقليدي. ويعكس هذا التوجه محاولة لاستكشاف طرق بديلة لتطوير أنظمة المحادثة، بحيث تتعلم التعامل مع الصوت مباشرة بدلًا من الاعتماد على مراحل معالجة نصية متتابعة. ومع ذلك، فإن عدم استخدام نموذج لغوي ضخم لا يعني بالضرورة أن النظام أكثر ذكاءً أو أقل تكلفة أو أفضل في جميع المهام. فهذه النتائج تعتمد على بنية النموذج وبيانات التدريب وقدرته على التعامل مع الأسئلة والمواقف المختلفة، وهي جوانب تحتاج إلى تقييم عملي.
لماذا تتيح Block النموذج للباحثين أولًا؟
بحسب التقرير، أتاحت الشركة فرصة تجربة النموذج لمجموعة محدودة من الباحثين المتخصصين في سلامة الذكاء الاصطناعي، بهدف التعرف على المخاطر المحتملة التي قد تظهر عند استخدامه. وتُعد هذه الخطوة مهمة عند تطوير أنظمة قادرة على التفاعل الصوتي المباشر، لأن سرعة الاستجابة وطبيعة المحادثة قد تثيران أسئلة تتعلق بالخصوصية وسوء الاستخدام ودقة فهم الكلام. كما يمكن أن يساعد الاختبار المبكر في اكتشاف حالات الفشل قبل توسيع نطاق الإتاحة. ولا يعني السماح لمجموعة محدودة بالتجربة أن النموذج أصبح متاحًا للجمهور، لذلك ينبغي متابعة الإعلانات الرسمية لمعرفة موعد الإطلاق وشروط الاستخدام.
هل ينافس Dessa نماذج ChatGPT وGemini؟
يختلف «Dessa» من حيث التوجه التقني عن المساعدات المرتبطة بنماذج عامة مثل «ChatGPT» و«Gemini»، إذ يركز على التفاعل الصوتي المباشر والتعلم من الصوت بدلًا من الاعتماد على نموذج لغوي ضخم بالطريقة التقليدية. لكن المقارنة بين هذه الأنظمة تحتاج إلى التمييز بين طبيعة المحادثة الصوتية وبين المعرفة العامة والاستدلال وتنفيذ المهام. فنجاح نظام في التفاعل الطبيعي لا يعني بالضرورة تفوقه في الإجابة عن الأسئلة المعقدة أو تحليل المعلومات. ولا تزال قدرات «Dessa» بحاجة إلى تقييمات أوسع ونتائج معلنة تسمح بمقارنته بصورة عادلة مع المساعدات المتاحة حاليًا.
الأسئلة الشائعة
ما نموذج Dessa؟
هو نموذج ذكاء اصطناعي صوتي طورته شركة «بلوك» التي أسسها جاك دورسي، ويركز على جعل المحادثات الصوتية أكثر طبيعية من خلال معالجة الصوت مباشرة.
هل يعمل Dessa دون إنترنت؟
تشير المعلومات المنشورة إلى إمكانية تشغيله محليًا على أجهزة ماك بوك المتطورة المتوافقة، دون الحاجة إلى اتصال دائم بالإنترنت.
ما الأجهزة المطلوبة لتشغيل النموذج؟
ذكر التقرير جهاز «MacBook Pro» المزود بمعالج «M4 Max» أو جهازًا أعلى قدرة، مع ضرورة متابعة المتطلبات الرسمية الكاملة.
هل يعتمد Dessa على نموذج لغوي ضخم؟
بحسب تصريحات جاك دورسي الواردة في التقرير، يعتمد النموذج على أسلوب الصوت إلى الصوت دون استخدام نموذج لغوي ضخم تقليدي.
ما المقصود بتقنية Full-Duplex Speech-to-Speech؟
هي تقنية تتيح للنظام الاستماع والتحدث في الوقت نفسه، بما يدعم تفاعلًا صوتيًا أكثر مرونة من الأنظمة التي تعتمد على تبادل الأدوار بصورة متتابعة.
هل أصبح النموذج متاحًا للجميع؟
تشير المعلومات الواردة إلى إتاحته في مرحلة بحثية لمجموعة محدودة من الباحثين، ولا ينبغي افتراض توفر نسخة عامة قبل إعلان الشركة ذلك.
هل يستطيع Dessa فهم المشاعر والسخرية؟
يستهدف النموذج التقاط إشارات صوتية مثل تغير النبرة والضحك والسخرية، لكن دقة هذه القدرات تحتاج إلى تقييمات عملية مستقلة.
هل يتفوق Dessa على ChatGPT وGemini؟
لا توجد معلومات كافية للجزم بذلك؛ فالمقارنة تحتاج إلى اختبارات تشمل جودة المحادثة الصوتية والمعرفة والاستدلال والأداء في المهام المختلفة.
يمثل نموذج «Dessa» تجربة بحثية في اتجاه تطوير الذكاء الاصطناعي الصوتي، مع التركيز على المحادثة المباشرة وإمكانية التشغيل المحلي على الأجهزة الشخصية. وإذا أثبتت هذه التقنية فاعليتها، فقد تفتح المجال أمام مساعدين صوتيين أكثر مرونة وأقل اعتمادًا على الاتصال السحابي. ومع ذلك، فإن الحكم على قدرات النموذج ومدى منافسته للأنظمة الحالية يتطلب انتظار نتائج الاختبارات وتفاصيل الإتاحة الرسمية، خاصة فيما يتعلق بالدقة والخصوصية ومتطلبات التشغيل.